 TÜRKİYE'NİN EN KAPSAMLI İŞ & İŞLETME VERİ MERKEZİ
Veri Analizi Ve İstatistiksel Modelleme
Başlangıç Rehberi
Bu Sektör Nedir?
Veri analizi ve istatistiksel modelleme sektörü, ham verilerin stratejik içgörülere dönüştürülerek kurumsal karar alma süreçlerinin optimize edilmesini sağlar. Modern işletmelerin rekabet avantajı elde etmesi için karmaşık veri setlerini anlamlandırma ve geleceğe yönelik tahminleme yapma yetkinliği kritik bir rol oynamaktadır. Bu sektör, matematiksel modeller ve ileri analitik teknikler kullanarak belirsizlikleri yönetilebilir risklere dönüştürür. Dijital dönüşümün merkezinde yer alan bu disiplin, veriye dayalı yönetim kültürünün temelini oluşturur. Profesyonel çözümlerle işletmelerin operasyonel verimliliğini ve karlılığını maksimize etmeyi hedefler.
Kimler İçin Uygun?
Finans ve bankacılık sektöründe risk yönetimi ve kredi skorlama ihtiyacı duyan kurumlar. Perakende ve e-ticaret şirketleri için müşteri segmentasyonu ve talep tahminleme hizmetleri. Üretim sektöründe kestirimci bakım ve süreç optimizasyonu arayan endüstriyel tesisler. Sağlık sektöründe klinik araştırma verilerini analiz etmek isteyen araştırma merkezleri. Pazarlama departmanları için kampanya performansı ve müşteri yaşam boyu değeri analizi yapan işletmeler. Kamu kurumları için sosyo-ekonomik veri analizi ve politika geliştirme süreçleri. Lojistik ve tedarik zinciri yönetimi yapan firmalar için rota ve stok optimizasyonu ihtiyaçları. Veri odaklı strateji geliştirmek isteyen orta ve büyük ölçekli tüm kurumsal yapılar.
İş Modeli Nasıl Çalışır?
Gelir modeli, proje bazlı danışmanlık ücretleri, uzun vadeli veri yönetimi abonelikleri ve özel yazılım geliştirme hizmetleri üzerine kuruludur. Ana faaliyetler arasında veri temizleme, keşifsel veri analizi, makine öğrenmesi modelleme ve görselleştirme süreçleri yer alır. Değer önerisi, müşterilerin verilerinden gizli kalıpları çıkararak maliyet tasarrufu sağlamak ve gelir artırıcı stratejiler geliştirmektir. Müşterilere sunulan dashboard ve raporlama araçları ile karar destek mekanizmalarının güçlendirilmesi sağlanır. Ayrıca, kurumsal veri okuryazarlığı eğitimleri ile ek gelir kanalları oluşturulur. Ölçeklenebilir bulut tabanlı analitik platformları üzerinden SaaS çözümleri sunulabilir. Başarı, modelin tahmin doğruluğu ve iş süreçlerine entegrasyon hızı ile ölçülür.
Fiziksel Alan İhtiyaçları
Yüksek hızlı internet altyapısına sahip, kesintisiz güç kaynakları ile desteklenen modern ofis ortamları gereklidir. Fiziksel konumun teknoloji parklarında veya iş merkezlerinde olması, yetenekli iş gücüne erişim ve prestij açısından avantaj sağlar. Ofis alanı, ekip çalışmasına uygun açık ofis düzenleri ve odaklanmayı gerektiren sessiz çalışma alanlarını içermelidir. Minimum 50-100 metrekarelik bir alan, başlangıç aşamasındaki bir ekip için yeterli olup, sunucu ve veri depolama üniteleri için iklimlendirilmiş özel bir oda ayrılmalıdır. Müşteri sunumları için yüksek çözünürlüklü ekranlar ve video konferans sistemleri ile donatılmış toplantı odaları zorunludur. Ergonomik çalışma istasyonları, uzun süreli veri işleme süreçlerinde personel verimliliğini artırmak için kritiktir.
Personel İhtiyaçları
Veri bilimciler, istatistiksel modelleme ve makine öğrenmesi algoritmaları konusunda uzmanlaşmış temel kadroyu oluşturur. Veri mühendisleri, veri hatlarının (pipeline) kurulması ve veri tabanı yönetimi süreçlerinden sorumludur. İş analistleri, teknik çıktıların iş stratejilerine tercüme edilmesi ve müşteri ilişkilerinin yönetilmesinde köprü görevi görür. Veri görselleştirme uzmanları, karmaşık analizlerin dashboardlar üzerinden anlaşılır kılınmasını sağlar. Proje yöneticileri, analitik süreçlerin zamanında ve bütçe dahilinde tamamlanmasını koordine eder. İhtiyaç duyulduğunda dış kaynaklı olarak siber güvenlik uzmanları ve bulut mimarları ile iş birliği yapılabilir. Ekip üyelerinin Python, R, SQL ve BI araçlarında ileri düzey yetkinliğe sahip olması beklenir.
Başlangıç İpuçları
Niş Belirleme
Genel veri analizi yerine sağlık, finans veya e-ticaret gibi dikey bir alanda uzmanlaşarak rekabet avantajı sağlayın.
Teknoloji Yığını Seçimi
Projelerin ölçeklenebilirliği için Python, R, SQL ve bulut tabanlı (AWS, GCP, Azure) araçlardan oluşan standart bir teknoloji yığını oluşturun.
Veri Gizliliği ve KVKK
Müşteri verilerini işlerken KVKK ve GDPR uyumluluğunu en baştan sağlayarak hukuki riskleri minimize edin.
Portföy Oluşturma
Gerçek dünya problemlerini çözdüğünüz, GitHub üzerinde barındırılan ve sonuçları görselleştirilmiş örnek projelerle yetkinliğinizi kanıtlayın.
İletişim Becerisi
Karmaşık istatistiksel modelleri, teknik olmayan paydaşların anlayabileceği iş odaklı içgörülere dönüştürme yeteneği geliştirin.
Fiyatlandırma Modeli
Saatlik ücret yerine, sağlanan katma değere veya proje bazlı çıktıya dayalı bir fiyatlandırma stratejisi benimseyin.
Otomasyon Odaklılık
Tekrarlayan veri temizleme ve raporlama süreçlerini otomatize ederek operasyonel verimliliğinizi artırın.
Sürekli Öğrenme
Makine öğrenmesi ve yapay zeka alanındaki hızlı değişimleri takip etmek için düzenli olarak sertifikasyon ve eğitim programlarına katılın.
Ağ Kurma
LinkedIn ve sektörel konferanslar aracılığıyla potansiyel iş ortakları ve karar vericilerle profesyonel ilişkiler geliştirin.
Kalite Kontrol
Modellerinizin doğruluğunu test etmek için çapraz doğrulama (cross-validation) ve hata analizi süreçlerini standart bir prosedür haline getirin.
Bulut Altyapısı
Veri işleme kapasitenizi artırmak için sunucusuz (serverless) mimarileri ve konteyner teknolojilerini (Docker, Kubernetes) öğrenin.
İş Geliştirme
Müşterilerinize sadece veri değil, bu veriden elde edilen aksiyon planlarını içeren stratejik danışmanlık hizmeti sunun.
Mesleki Bilgi ve Referans Merkezi
Sektörel mesleki standartlar, parametreler ve referans rehberleri.
Veri Kalitesi
Analiz Öncesi Veri Kalitesi ve Tutarlılık Kontrolü
Modelleme başlamadan önce değişken tipleri, benzersiz kayıt sayıları, Kayıp Veri oranları, minimum ve maksimum değerler ve kategorik seviyeler kontrol edilmelidir. Her değişken için beklenen aralık ve iş kuralı tanımlanarak fiziksel olarak veya iş mantığı açısından imkânsız değerler ayrı bir kalite raporunda işaretlenir. Yinelenen kayıtlar, anahtar alanların benzersizliği ve tablolar arası Foreign Key ilişkileri ayrıca doğrulanmalıdır. Kayıp Veri oranları değişken ve gözlem bazında raporlanmalı; MCAR, MAR veya NMAR varsayımlarından hangisinin makul olduğu belirlenmeden otomatik İmputasyon uygulanmamalıdır.
Veri Seti Boyut ve Ölçek Hesaplayıcı
Analiz projelerinde veri setinin boyutunu, örnekleme oranlarını ve ölçek değişimlerini hesaplar.
Hesaplanan Sonuçlar
Model Performans Karar Analizi
Makine öğrenmesi modellerini doğruluk, hız, karmaşıklık ve kaynak ihtiyacına göre karşılaştırarak öneri üretir.
Hesaplanan Sonuçlar
İstatistiksel Örneklem Hesaplayıcı
Araştırma ve analiz çalışmaları için güven seviyesine göre gerekli örneklem büyüklüğünü planlar.
| Kaynak Anahtarı | Kaynak Adı | Miktar/Adet | Kapasite Modu | İşlem Süresi (Dk) | Birim Kapasite (Adet/Sa) | Throughput Kısıtı mı? |
|---|
Hesaplanan Sonuçlar
Dashboard Grafik Alan Hesaplayıcı
Veri görselleştirme ekranlarında grafik, tablo ve gösterge alanlarının güvenli yerleşimini hesaplar.
Hesaplanan Sonuçlar
İstatistik Rapor Okunabilirlik Simülatörü
Analiz raporları, tablolar ve grafik açıklamalarının farklı ekran mesafelerinde okunabilirliğini değerlendirir.
Hesaplanan Sonuçlar
İstatistik Model Rapor Format Dönüşümü
Analiz çıktılarının farklı rapor formatlarına uygun oran ve boyutlarda hazırlanmasına yardımcı olur.
Hesaplanan Sonuçlar
Veri Analiz Pipeline Bileşen Oranlama
Veri işleme, temizleme, modelleme ve raporlama aşamalarının kaynak dağılımını oranlar.
| Bileşen Anahtarı | Bileşen Adı | Baz Miktar | Sabit mi? | Sabit Değer |
|---|
Hesaplanan Sonuçlar
Standart Operasyonel İş Akışları
Sektör standartlarına uygun iş akış ve süreç adımları.
Analiz Amacını ve Hedef Değişkeni Tanımlama
İş sorusu, analiz birimi, hedef değişken, karar kriterleri ve başarı metriği yazılı olarak tanımlanır. Tahmin, sınıflandırma, nedensel analiz veya betimsel analiz hedeflerinden hangisinin kullanılacağı netleştirilir.
Veri Kaynaklarını Envantere Alma
Kullanılacak veri setleri, tablolar, dosyalar ve veri üretim sistemleri listelenir. Her kaynak için sahiplik, güncelleme sıklığı, kapsam tarihi, anahtar alanlar ve veri erişim yöntemi kaydedilir.
Şema ve Veri Tiplerini Doğrulama
Sayısal, kategorik, metin ve tarih alanlarının veri tipleri kontrol edilir. Tarih alanlarının timezone bilgisi, kategorik seviyelerin tutarlılığı ve sayısal alanların ölçüm birimleri doğrulanır.
Veri Kalitesi Raporunu Oluşturma
Kayıp Veri oranı, duplicate kayıtlar, aykırı değerler, benzersiz değer sayıları, beklenmeyen kategoriler ve iş kurallarına aykırı gözlemler raporlanır. Modelleme öncesinde düzeltilmesi gereken kalite sorunları önceliklendirilir.
Operasyonel Kontrol Listeleri
Günlük rutinleri tarayıcınızda saklanacak şekilde takip edin.
Günlük Veri Kalitesi Kontrol Checklisti
%0Haftalık Veri Kaynağı Sağlık Checklisti
%0Haftalık Model Performans İzleme Checklisti
%0Haftalık Data Drift Kontrol Checklisti
%0Aylık Model Versiyonlama ve Lineage Checklisti
%0Haftalık İstatistiksel Analiz Kalite Checklisti
%0Haftalık Deney ve A/B Testi Takip Checklisti
%0Haftalık Zaman Serisi İzleme Checklisti
%0Haftalık Üretim Tahmin Servisi Operasyon Checklisti
%0Aylık Analiz ve Model Raporlama Checklisti
%0Sorun / Çözüm Kütüphanesi
Veri Analizi Ve İstatistiksel Modelleme sektöründe karşılaşılabilecek teknik ve operasyonel sorunlar için çözüm ve teşhis rehberi.
Büyük Veri Kümelemelerinde (Big Data) Kayıp Veri (Missing Data) Doldurma Yöntemi Nedeniyle Varyans Sapması
Eksik verilerin (Missing At Random - MAR) ortalama veya medyan ile basitçe doldurulması (imputation) sonucunda veri dağılımının varyansının yapay olarak daralması ve korelasyon matrisinin bozulması.
İmputasyon öncesi ve sonrası veri dağılımının varyansları, basıklık (kurtosis) ve çarpıklık (skewness) değerleri istatistiksel testlerle (Little's MCAR testi) karşılaştırılır.
Basit doldurma yerine Çoklu İmputasyon (Multiple Imputation by Chained Equations - MICE) veya KNN tabanlı imputasyon yöntemleri uygulanarak belirsizlik korunur.
Çoklu Doğrusal Bağlantı (Multicollinearity) Nedeniyle Regresyon Katsayılarının Anlamlılığını Yitirmesi
Bağımsız değişkenler arasında yüksek düzeyde doğrusal ilişki (korelasyon) bulunması nedeniyle en küçük kareler (OLS) tahminleyicilerinin varyansının aşırı büyümesi ve t-istatistiklerinin güvenilir olmaması.
Varyans Enflasyon Faktörü (VIF) değerleri hesaplanır; VIF > 10 olan değişkenler tespit edilir ve korelasyon matrisi incelenir.
Yüksek VIF değerine sahip değişkenler modelden çıkarılır veya Ridge ve Lasso gibi düzenlileştirme (regularization) teknikleri uygulanır.
Dengesiz Veri Sınıflarında (Imbalanced Dataset) Model Performans Yanılgısı (Accuracy Paradox)
Sınıf dağılımının aşırı dengesiz olduğu (örn. %99 normal, %1 dolandırıcılık) senaryolarda modelin tüm gözlemleri çoğunluk sınıfına tahmin ederek yüksek accuracy (doğruluk) skoru üretmesi ancak azınlık sınıfını tamamen kaçırması.
Karmaşıklık matrisi (Confusion Matrix) çıkarılır; Precision, Recall, F1-Score ve ROC-AUC metrikleri hesaplanır.
SMOTE (Synthetic Minority Over-sampling Technique) ile veri dengelenir, kayıp fonksiyonuna maliyet matrisi (class weights) eklenir ve metrik olarak F1-Score veya PR-AUC kullanılır.
Zaman Serisi Modellerinde (ARIMA/SARIMA) Durağanlık (Stationarity) Olmaması Nedeniyle Sahte Regresyon (Spurious Regression)
Zaman serisinin ortalamasının veya varyansının zamana bağlı olarak değişmesi (non-stationary), otokorelasyon yüksekliği nedeniyle gerçekte ilişkisi olmayan seriler arasında yüksek R-kare değerleri çıkması.
Genişletilmiş Dickey-Fuller (ADF) testi ve Kwiatkowski-Phillips-Schmidt-Shin (KPSS) testleri uygulanarak birim kök (unit root) varlığı kontrol edilir.
Seri uygun mertebede fark (differencing) alma işlemine tabi tutulur veya logaritmik dönüşümle varyans stabilize edilerek durağan hale getirilir.
Çoklu Hipotez Testlerinde (Multiple Hypothesis Testing) Yanıltıcı İstatistiksel Anlamlılık (Type I Error Artışı)
Aynı veri seti üzerinde çok sayıda ikili hipotez testi (A/B testing veya genetik taramalar) yapıldığında, alfa önem seviyesi (%5) nedeniyle şans eseri anlamlı sonuçlar (False Positive) elde edilmesi.
Gerçekleştirilen toplam test sayısı ile p-değerlerinin dağılımı (Bonferroni veya FDR grafikleriyle) incelenir.
Bonferroni düzeltmesi veya Benjamini-Hochberg (FDR - False Discovery Rate) prosedürü uygulanarak p-değerleri eşik sınırına göre ayarlanır.
Yüksek Boyutlu Verilerde Lanet (Curse of Dimensionality) Nedeniyle Model Aşırı Uydurması (Overfitting)
Gözlem sayısına kıyasla öznitelik (feature) sayısının çok fazla olması durumunda modelin evrensel örüntüleri değil gürültüyü (noise) öğrenmesi.
Eğitim (train) ve test veri setlerindeki performans metrikleri (RMSE, Accuracy) kıyaslanarak büyük farklar aranır.
Temel Bileşen Analizi (PCA) veya doğrusal olamayan manifold öğrenme yöntemleri ile boyut indirgenir, L1/L2 regularizasyon uygulanır.
K-Means Kümeleme Algoritmasında Başlangıç Merkezine (Initial Centroids) Hassasiyet ve Yerel Optimum
K-Means algoritmasının başlangıçta rastgele seçilen merkez noktalarına bağımlı olması nedeniyle suboptimal (yerel optimum) kümeleme sonuçları üretmesi.
Farklı rastgele başlangıç tohumları (random seeds) ile çalıştırılan kümelerin inertia (küme içi hata kareler toplamı) değerleri kıyaslanır.
K-Means++ algoritması kullanılarak başlangıç merkezleri birbirinden uzak optimal noktalardan seçilir ve siluet skoru (Silhouette Score) ile optimize edilir.
Eğitilen Modelin Üretim Ortamında Veri Kayması (Data Drift / Covariate Shift) Nedeniyle Performans Kaybı
Zaman içinde üretim ortamına gelen yeni verilerin istatistiksel dağılımının, modelin eğitildiği eğitim verisi dağılımından kökten farklılaşması.
Production verisi ile eğitim verisi arasındaki özellik dağılımları Population Stability Index (PSI) ve Kolmogorov-Smirnov testi ile izlenir.
MLOps izleme panelleri (Monitoring Dashboards) kurulur, PSI > 0.25 eşiği aşıldığında otomatik model yeniden eğitim (retraining) pipeline'ı tetiklenir.
Sayısal Değişkenlerde Aşırı Değerlerin (Outliers) Model Katsayılarını Manipüle Etmesi
Veri setindeki uç değerlerin (outliers) ortalamayı ve standart sapmayı çarpıtarak özellikle parametrik modellerde (Lineer Regresyon vb.) yanlı tahminlere yol açması.
Kutu grafikleri (Boxplot), Z-score (Z-skoru > 3) ve Çeyrekler Arası Aralık (IQR) sınırları hesaplanarak uç değerler tespit edilir.
Uç değerler iş mantığına göre temizlenir, winsorization (kırpma/sınırlama) yöntemi uygulanır veya sağlam (robust) regresyon modelleri tercih edilir.
Lojistik Regresyonda Tam Ayrılma (Complete / Quasi-Complete Separation) Sorunu
Bağımsız bir değişkenin veya doğrusal kombinasyonunun hedef sınıfı kusursuz bir şekilde (hiç hata payı bırakmadan) ayırması sonucunda katsayı tahminlerinin sonsuza gitmesi.
Lojistik regresyon optimizasyon iterasyonlarında (convergence) katsayıların patlaması ve standart hataların devasa değerler alması incelenir.
Firth'in penalized likelihood (cezalı olabilirlik) yöntemi uygulanır veya çakışan gözlemler için ridge cezası eklenir.
Zaman Serisi veya Panel Verilerde Cross-Validation (Çapraz Doğrulama) Sırasında Veri Sızıntısı (Data Leakage)
Standart K-Fold cross-validation kullanılırken gelecekteki gözlemlerin rastgele seçilerek eğitim setine dahil edilmesi ve modelin geleceği 'bilerek' test etmesi.
Çapraz doğrulama fold bölme indekslerinin tarihsel zaman sırasını ihlal edip etmediği (future data in train) gözden geçirilir.
Zaman serisi ve ardışık veriler için TimeSeriesSplit (rolling/expanding window) çapraz doğrulama stratejisi zorunlu kılınır.
Mevsimsel Zaman Serilerinde Girdi Verisinde Eksik Değerler Nedeniyle STL Ayrıştırma Hatası
Mevsimsellik içeren zaman serilerinde aralıklı eksik verilerin olması, STL (Seasonal and Trend decomposition using Loess) veya Holt-Winters algoritmalarının döngüsel hesaplamalarını kesintiye uğratması.
Zaman serisi indeks aralığındaki eksik tarihler (gaps) frekans kontrolüyle tespit edilir.
Eksik zaman damgaları lineer interpolasyon veya spline interpolasyon ile doldurulur, ardından mevsimsel ayrıştırma çalıştırılır.
Reklam & Pazarlama Fikir Havuzu
İşletmenizin marka değerini artıracak, fiziksel ve dijital reklam stratejileri.
Tasarım İlham Merkezi
Kurumsal Kimlik & Tasarım Örnekleri
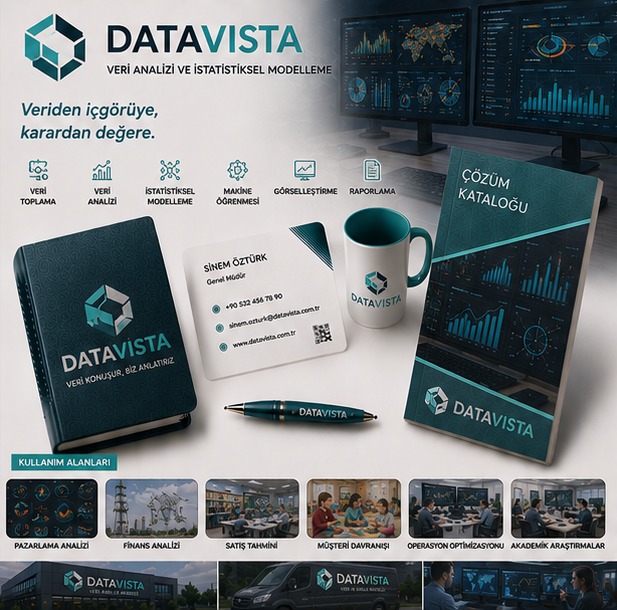
Logo Tasarım Örnekleri

Veri Analizi Ve İstatistiksel Modelleme Logosunda Dikkat Edilmesi Gerekenler
Logo tasarım rehber kriterleri analiz ediliyor...
Sektörel Hesaplama ve Araç Rehberleri
Bu sektör için özel olarak geliştirilmiş ücretsiz SEO ve hesaplama araçlarıBu Sektörde Başarıya Ulaşın
Markanıza ait profesyonel tasarım, web sitesi, mobil uygulama ve pazarlama süreçlerinde birlikte çalışalım.
Bizimle İletişime Geçin